Ce qu’il faut savoir sur le Daily Scrum
(via http://www.youtube.com/attribution_link?a=Zg-yIKJZVbk&u=/watch?v=MR88bbHf0wA&feature=share)
(Source: https://www.youtube.com/)
(via http://www.youtube.com/attribution_link?a=Zg-yIKJZVbk&u=/watch?v=MR88bbHf0wA&feature=share)
Comme chaque année, il y a de nombreuses sessions que je n’ai pu voir. Je vais tenter d’y remédier en partie dans ce post.
Pour rappel les autres présentations, celles auxquelles j’ai assisté, sont couvertes ici et ici pour la journée du Jeudi. Elles sont ici et ici pour le Vendredi.
Cyrille Deruelle, en plus de sa présentation sur l’amélioration continue, a proposé ce sujet sur les projets agiles. Quelques clés et rappels pour ne pas pervertir nos pratiques et garder le cap sur ce qui est important.
Patrick Bobo a par ailleurs développé le contenu de cette session dans un post.
The real lessons in software development come from production. The more frequently you can deploy, the more feedback you can generate.
J’en fais déjà une tradition : le blog va passer en régime estival. Essayons d’en dire plus.
L’an dernier, je vous avais fait part de gros changements. Ce ne sera pas le cas cette année, heureusement ! En fait, j’ai plusieurs petits projets personnels en cours ou à venir pour lesquels je dois me ménager un peu de temps. Mais il ne sert pas à grand chose d’en parler tant qu’ils ne sont pas arrivés à maturité.
Oui, il faut y penser dès à présent ! Il y a bien sûr des conférences et principalement la série des agile tours ! Le programme n’est pas encore fixé, mais je vise 3 présences sur ce dernier trimestre pas plus. Il reste à déterminer sur quels évènements.
Malgré les sarcasmes de mes confrères, je suis bien décidé à vous relivrer mes notes de lecture has been (je pense à Pablo et Alfred, principalement…). J’en ai un paquet à écouler, donc ce ne sera pas la dernière année. Dans l’ensemble il devrait s’agir de textes accusant une vingtaine d’année environ !
Toujours dans la séquence nostalgie, j’ai aussi quelques articles écrits il y a une dizaine d’année d’année. J’attendais une opportunité pour les replacer : ce sera fait !
Ce n’est pas très logique de sortir ce genre d’écrits à l’époque où la fréquentation baisse, mais je récidive dans cette voie.
Ce sont 5 opus que je vous ai livré sur les deux années précédentes. Ont déjà subi mon traitement impitoyable :
Je vise 3 sujets pour cet été. Cela parait peu, mais ces posts me demandent vraiment beaucoup de travail et de recherche. L’an dernier, je me suis même limité à deux ! Je vous laisse deviner les sujets que je me prépare à aborder. Vous pouvez laisser un commentaire si vous avez une idée.
L’été commencera le 1er Juillet ! A très bientôt.
Note: 7 ; Du Web Service à l’ESB
Tout d’abord une précision: si vous cherchez un ouvrage sur la mise en oeuvre technique des Web Services, ce n’est pas le bon livre. Cela dit, il en existe plein et celui-ci viendra en complément, car ce livre ne traite pas de mise en œuvre technique, mais d’aspect architecturaux liés à l’utilisation des Web Services dans un contexte SOA. Les grandes questions que pose cet ouvrage sont : comment puis-je utiliser les Web Services pour effectuer l’intégration de systèmes ? Quels sont les briques technologiques qui manquent et comment les compenser ? Bien sûr, ayant lu ce livre presque 5 ans après sa parution, j’en ai raté l’approche novatrice en bonne partie car ce sont ni plus ni moins que les bases de l’ESB que l’auteur pose ici ! Mais même en arrivant après la bataille, le texte éclaire l’approche Web Service proposée ici (attachement + couplage faible + asynchronisme) qui a été emmprunté par l’ESB et peut nous permettre de mieux exploiter ceux-ci correctement. Allons voir plus en détail le contenu des 320 pages de l’ouvrage.
Le livre est intelligemment découpés en 20 chapitres dont la longueur varie de 10 à 25 pages. Le format du livre étant également plus petit qu’à l’accoutumée, chaque chapitre se lit donc aisément, ce qui est une bonne chose.
La première partie, intitulée « perspectives » est composée de 5 chapitres. Elle campe les besoins d’infrastructures d’une architecture d’intégration de services, d’abord en rappelant l’historique au chapitre 1 (Corba, COM, DCE, EAI, etc…), ce qui est synthétique et bien fait. Ensuite le chapitre 2 met en perspective les Web Services avec les technologies vues précédemment et les avantages relatifs de cette technologie. Le chapitre 3 nous projette dans l’extrapolation, l’évolution des technologies « en devenir » et des « mainstream » pour stigmatiser l’importance des Web Services. Les chapitres 4 et 5 sont complémentaires et servent de charnière pour le reste du livre : que manque-t-il à la technologie Web Services pour être une pièce maîtrise du SOA et de l’intégration de services.
Aux 58 pages de cette première partie succède une seconde partie longue de 82 pages et intitulée « concepts ». les 5 chapitres qui la compose détaillent les paradigmes que l’auteur juge importants par rapport au SOA. Le chapitre 6 développe la volet intégration et poursuit une discussion commencée au chapitre 2. Les chapitres 7 et 8 nous aident à comprendre les corollaires d’une architecture d’intégration basée sur les Web Services et pourquoi le style orienté document doit être favorisé par rapport au style RPC. Les chapitres 8 et 9 sont dédiés à l’architecture asynchrone et pourquoi ce style doit être favorisé en intégration de services.
La troisième partie « technologies » est consacrée … eh bien au volet technologique ! Ce sont de nouveau 5 chapitres et 90 pages qui sont dédiés à cette avant-dernière partie. Le volet « sécurité » s’y taille la part du lion, avec 2 chapitres et 46 pages. Le premier chapitres met en évidence les besoins (intégrité, authentification, non-répudiation, etc…) rien de bien original mais fort bien expliqué. Le second chapitre propose des solutions, bien que celles-ci soient souvent, disons originales (comme le XML firewall). Un chapitre est consacré aux transactions et plus précisément aux transactions applicatives. La surcouche orchestration n’est évoquée que brièvement car elle sort du cadre de cet ouvrage, tout comme l’aspect déploiement qui est traité assez légèrement.
La dernière partie « stratégie » interpelle les managers. Quid de la qualité de service (chapitre 16) ? Qu’en est-il des SLA et de l’externalisation de services (chapitres 19 et 20). Enfin la gestion de projets d’intégration est traitée aux chapitres 17 et 18.
Bref, voilà un ouvrage qui vaut le détour. Il n’est pas purement technique et ne vous apprendra pas à développer ou utiliser des Web Services mais donne des clés pour créer une architecture intelligente basée sur cette technologie.

Référence complète : Loosely Coupled, the missing pieces of web services – Doug Kaye – RDS press 2003 – ISBN : 1-881378-24-1 ; EAN : 9 781881 378242

Rien ne nous trompe autant que notre jugement.
“Let’s organize this thing and take all the fun out of it” — Ashleigh Brilliant
I’m aware that some folk think I like to dismiss project/program managers as unnecessary overhead in organizations, so I’ll start by saying I know some wonderful people who work under these titles. This post is not…
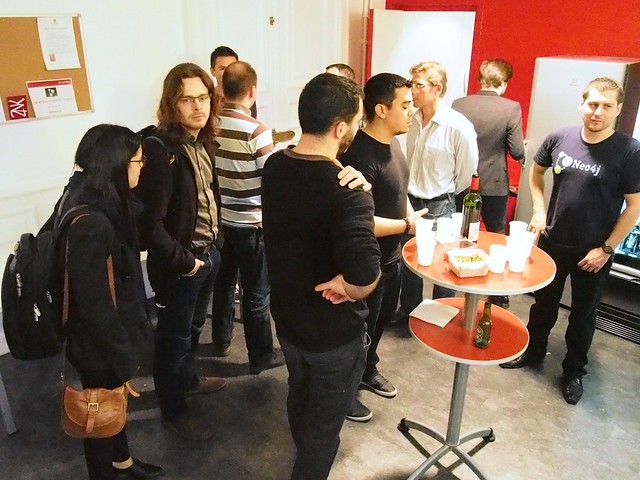
Il y avait un petit moment que l’on n’avait pas eu de meetup Neo4J sur Paris ! C’est donc avec une façon un peu provocante d’aborder un sujet à connotation BI que nous avons été invités !
Nous étions environ 30 à nous rendre ainsi dans le showroom Zenika.
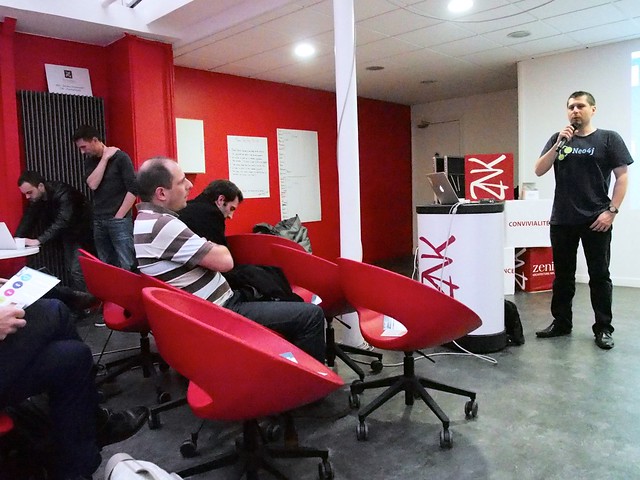
Cédric Fauvet, toujours égal à lui-même nous fait son habituelle introduction sur les graphes. Presque habituelle, devrais-je dire, car il fait un peu évoluer son propos de meetup en meetup, tout comme son support.
Aujourd’hui, le spectre des problèmes couverts par les bases orientées graphes couvre :
En Juin, Neo4J France devrait nous gratifier d’une présentation d’un projet « Dropbox-like » réalisé par des étudiants !
Cédric attire également notre attention sur le talk de Volker Pacher expliquant pourquoi Neo4J augmentait la capacité de delivery de Shutl (acquis depuis par eBay).
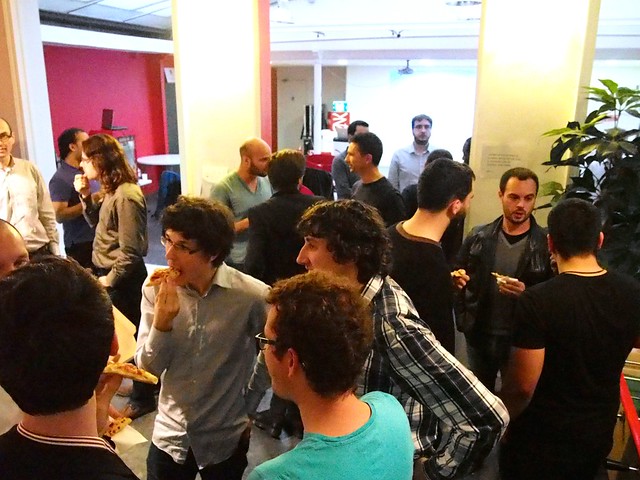
Il est l’heure de la pause pizza, nous allons bientôt attaquer la pièce maîtresse de la soirée !
Nicolas Mervaillies et Charles Besselièvre nous présentent le projet qu’ils ont développé pour « un grand client retail ». Il s’agit d’un petit projet, c’est à dire moins de 100 j/h, qui devait être développé rapidement. Sur les projets analytiques orientés « real time », cette enseigne s’appuie généralement sur SAP Hana. Mais ce projet tactique présente des échéances de temps incompatibles avec ce type de projet, plus adapté à des solutions légères menées en agile.
La problématique est essentiellement simple : trouver des corrélations d’achats. Vous savez, celles qui ont permit de déterminer que les couches culottes sont souvent achetées en même temps que le bière le samedi ou qui ont permit à une enseigne d’apprendre via des bons d’achat à une jeune fille qu’elle était enceinte avant qu’elle même ne le sache ! Ici les corrélations doivent être croisées entre magasins et entre régions. Pour chaque magasin, il faut compter une volumétrie de 300 millions de lignes de ticket par an.
Pour cela on utilise simplement la console Neo4J ! En fait, on ne représente pas chaque ligne d’achat en liaison avec le ticket de caisse : on agrège ces lignes par sous-familles. Bien sûr, les tickets sont associés à une date, un client et un magasin.
Grâce à cela, on voit avec Cypher si l’on parvient à produire les analyses que l’on souhaite.
Premier fonctionnement en production : les données de ticket de caisse sont récupérés tous les mois et injectés avec Spring Batch. Le client peut agréger les données en live via des requêtes Cypher : dans le temps, par famille de produits, par magasin.
Les couplages repérés avec de forts pourcentages sont donc mis en exergue dans certains magasins, on compare les éléments différenciants des magasins ayant de moins bons taux de corrélation !
On a toutefois un problème : trop de lenteurs, dû aux fortes volumétries, mais aussi au déploiement de Neo4J sur des serveurs virtualisés. La virtualisation et les bases de données, ce n’est pas le grand amour, même si certains ingénieurs système essaient de se convaincre du contraire !
En analysant les données des différents magasins, on perçoit dans le temps des réccurrences d’association, notamment dans le « top 15 ». Nos artistes choisissent donc de précalculer les associations significatives, celles correspondant au « top 50 » de chaque magasin, mais sans Marc Toesca !
En dernière phase, il faut finalement réaliser des optimisations purement de production : gestion de l’infrastructure, mise en place de cache, etc…
L’utilisation de Neo4J est parfaitement adaptée à ce type de projet tactique : on a la rapidité de de mise en place et la vitesse d’exécution de ce projet typique d’un projet agile ! Par rapport à SAP Hana, on gagne réellement en time to market !
L’équipe a aussi développé un front-end pour faciliter l’utilisation du système. Mais à la limite, cela aurait pu être omis !
Concernant l’infra : elle a été gérée complètement en interne pour des raisons de non exposition de données sensibles. Toutefois, on a une machine puissante qui ne sert que quelques heures, une fois par mois ! Ce type de configuration se marrie donc bien avec le Cloud.
Enfin, l’aspect communautaire de Neo4J permettant de trouver de l’aide sur les forum a été un plus important !
Faute de disposer du support de présentation, je vous propose ici l’enregistrement de la même session qui s’est déroulée au meetup Neo4J Lillois !
C’est probablement le meetup Neo4J le plus interactif et le plus convivial auquel j’ai pu assister. Les interventions fort pertinentes d’un connaisseur SAP Hana ont été un gros plus dans la discussion, surtout quand, comme lui, on connait et sait reconnaitre les qualités de ce système. Il est là, juste derrière moi.

Pour clore ce compte-rendu et donner un avis éclairé sur cette confrontation, je le citerai :
« Remplaçons notre argent par notre intelligence ».
Cela me rappelle un peu un slogan des années 70 où il était question de pétrole…
The best way to screw up the usefulness of any process metric is to use it to judge people.
Nous voici arrivés au bout de notre périple. Les épisodes précédents sont disponibles ici et ici pour la journée du Jeudi, et ici pour le vendredi matin.
Au programme de cette dernière après-midi : des demi-sessions (dont la mienne) et une clôture de l’évènement toute particulière !
Je ne connaissais pas Matti. Je dois dire qu’il m’a bluffé par son niveau de maturité en agilité et la qualité de ses analyses. Peut-être est-ce lié au fait qu’en plus d’être ingénieur, il est également étudiant en anthropologie ?

Matti évoque pour nous l’amélioration continue, avec une approche qui sort des très classiques rétrospective et est d’avantage « centrée artéfacts ».
Le point essentiel de la présentation est l’utilisation d’un outil (oui !), en fait un tableau, qui va guider l’équipe d’une façon particulière : faire entrer en résonance le descriptif et le prescriptif par le biais de cet outil !
Quand un changement de workflow est pressenti : le tableau change et devient prescriptif. Et comme l’équipe suit ce tableau, il devient alors prescriptif. Le tableau évolue par le biais de l’équipe de production qui est elle-même une partie de l’outil de production ainsi décrit.
Le passage d’une étape à une autre fait l’objet d’un « point fixe » : un état que l’on sait parfaitement définir par lequel passe obligatoirement les items. En dehors de ces points fixes, la façon dont évoluent ces items peut varier !
Voilà qui rappelle une citation de McLuhan : nous façonnons nos outils et eux-même à leur tour nous façonnent ! Et la façon dont nous les façonnons passe au travers de nos interactions.
Cette approche, à la base une variante des classiques rétrospectives agiles, est issu de Crystal Clear d’Alistair Cockburn. L’incarnation qu’en fait Matti est au travers d’un board synthétisant les décisions prises au long des itérations ! On a donc une vue d’ensemble de la chose. Les règles sont d’abord simples (dans les premiers sprints) et deviennent de plus en plus pointues. Elles peuvent aussi être changées / abandonnées, on leur superposent alors un post-it bleu avec le numéro de l’itération à l’origine de ce changement.
Les tickets agissent comme des « reminders » évitant de réitérer une discussion sur laquelle il y a déjà eu un accord. Certains guides focalisent sur l’usage du board lui-même, une sorte de niveau méta…
Une présentation remarquable qui traduit une maturité tout aussi remarquable. Ce fut ma présentation préférée de cette après-midi là.
Ce n’est pas souvent que Géry nous gratifie d’une session qui n’est pas un atelier. En fait, c’est la première fois que j’y assiste ! Géry avait envie de partager depuis longtemps ce qui l’attire sur la pensée de Ludwig Wittgenstein. Une session pas très facile à suivre et encore moins facile à retranscrire !

Le plus simple est problement de ne pas faire de retranscription. Je vais simplement relever certains éléments que j’ai noté au fur et à mesure de la présentation de Géry.
Cette façon de pensée amène Géry, en tant que coach, à demander au coaché de « déconstruire » les constats par une question : comment le savez-vous ?
C’est aussi ce mode de pensée qui a amené Gery vers le solution focus qu’il voit comme une incarnation de la pensée de Wittgenstein.
Une session difficile à suivre qui nous amène vers les sentiers d’une philosophie à contre-courant. Je ne suis certainement pas rompu à cet exercice (je n’ai même pas d’épreuve de philo dans mon bac technique !). Bref, je passe pour l’instant…
Hélas, j’ai assez peu suivi la session de Pierre. Il faut dire qu’elle précédait juste la mienne. Au minimum pour commencer, je peux vous en livrer le teaser.
Pourtant cette session s’articule autour d’un de mes sujets préférés : les biais cognitifs ! Pierre évoque ainsi quelques mécanismes :
Le cerveau humain juge souvent en relatif. Si on fournit une référence, elle biaise les résultats obtenus, par le haut ou par le bas, suivant que le référence d’origine est haute ou basse respectivement !
Le planning poker, en exigeant que les cartes soient montrées en même temps cherchent à éradiquer ce biais.

S’identifier à une personne est plus fort que s’adosser à des statistiques ! Le mécanisme des persona s’appuie sur cela (en lieu et place des rôles, plus abstraits).
Essentiellement que je suis frustré de n’avoir pas mieux suivi cette session. Damnation ! Car le sujet m’intéresse au plus haut point. Mais je ne peux en vouloir qu’à moi-même. J’espère que le support ou mieux l’enregistrement sera bientôt disponible…
C’est mon tour ! Au programme une version plus dense, en partie raccourcie et en partie modifiée de ma présentation faite à Agile Grenoble 2013. J’ai dans ma liste de tâches, la rédaction de cette présentation sous forme d’article, comme je l’ai fait pour Scrum Shu Ha Ri.
Je publierai aussi sous peu la nouvelle version correspondante du support.
Cette dernière demi-session ne fut pas ma préférée de l’après-midi, bien au contraire. Le but était en principe de démystifier certains de ces buzzwords, de les dégonfler. En fait, je me suis trouvé en désaccord avec nombre des assertions de Christopher et Hervé !

Bref, pas enthousiasmé par cette session. Mais alors, pas du tout…
Le scribing était notre grand fil rouge de la conférence. Pour clore en beauté celui-ci, Romain nous a invité à élaborer en commun une grande fresque faisant le tour de la salle Belvédère. Un bel exercice !

L’organisation d’Agile France nous réservait une petite surprise pour clore ces deux jours : une fausse session proposée avec talent par la compagnie des Z’Humbles.

Drôle et bien enlevé. C’est une façon originale de terminer cet Agile France !

Une formule en grand changement pour cette nouvelle édition, avec deux après-midi à caractère spécifique, sans oublier le fil rouge de Romain. Toujours une grande qualité dans les sessions et la magie du Chalet de Porte Jaune ! Les organisateurs ont réellement redoublé d’efforts pour réussir cette nouvelle édition.


