‘Oh, you can’t help that,’ said the cat. ‘We’re all mad here.’
Lewis Carroll in Alice in Wonderland

‘Oh, you can’t help that,’ said the cat. ‘We’re all mad here.’
Lewis Carroll in Alice in Wonderland
Les agilistes ne sont guère friands de normes et autres standards. Généralement, nous nous contentons de les ignorer. Néanmoins ils sont souvent utiles.
Continuer à lire « La résistance contre l’ISO 29119 s’organise ! »
Note : 6 ; Pas les progrès espérés de cette seconde édition considérablement étoffée, mais avec une notation qui continue à se rapprocher de Rational plus que de UML / MDA
Seconde édition d’un ouvrage paru en 2000, ce volume considérable (450 pages), dont un tiers est consacré aux annexes. La première édition montrait une ébauche de profile UML pour les applications Web. Depuis un certain nombre de spécialisations ont vu le jour, notamment dans le monde JEE. Voyons ce qu’il en est.
Comme je l’ai dit, le corps principal du livre compte 300 pages, repartis en 2 parties et découpé en 12 chapitres. La première partie est consacrée à la modélisation des technologies relatives au Web et rassemble les 5 premiers chapitres. Le premier chapitre sert d’introduction et couvre 3 pages, n’en parlons pas. Le chapitre 2 est en fait la réelle introduction. Sur 20 pages, il fait le point sur les principales technologies et protocoles qui sont le quotidien des applications Web à la date de l’ouvrage. C’est plutôt bien écrit mais on y apprend pas grand chose.
Le chapitre 3 s’intitule « dynamic client ». On y évoque tout ce qui tourne autour du DOM, et ce n’est pas particulièrement superficiel. Il y a quelques tentatives timides de modélisation. Il est dommage qu’elles soient timides, car elles sont plutôt originales et bien pensées. C’est un chapitre court de 10 pages.
Anyone who has a continuous smile on his face conceals a toughness that is almost frightening.
Greta Garbo (via shaira11000)

Cet article est réellement le premier à présenter Scrum, c’était en 1995. Petit détail que j’ignorais, Ken Schwaber l’a mis en oeuvre pour le développement de Delphi ! Déjà l’auteur présente son approche comme étant « boite noire » et empirique, bien adapté au développement de systèmes complexes. Et oui, Scrum est bien en rapport avec le Rugby !
Bien sûr, à cette époque, il n’était pas encore question du mot « agile ». Ken Schwaber situe Scrum comme une évolution des procesus itératifs, non comme une disruption.
Quand il parle du développement logiciel, c’est toujours à la notion de complexité que revient l’auteur. Il la définit comme suit :
Complexité = f(dev. environnement var. + target env. var.)
Toutes ces varaibles changeant par ailleurs au cours du projet.
Deux intellectuels assis vont moins loin qu’une brute qui marche !
Michel Audiard in Un taxi pour Tobrouk

Note : 6 ; De l’Eclipse au kilo !
Voici un pavé, du vrai, du gros, du 1000 pages ! Ce gros pavé, justement, se veut la bible du développement avec et pour Eclipse. Honnêtement, cet ouvrage semble venir d’un autre temps, celui où l’on payait les livres au kilo ! Celui-ci n’est plus tout neuf, mais il me semble que même à cette époque cette tendance s’estompait. Et plus encore chez Addison Wesley. Le livre compte 34 chapitres et je n’ai franchement pas l’envie de tous les passer en revue. Heureusement, ceux-ci sont regroupés en 6 parties, ce qui rend plus huain le survol du texte.
La première partie couvre près de 200 pages et est consacrée à l’utilisation d’Eclipse. Les 6 chapitres qui la compose noircissent beaucoup de papier pour dire en grande partie ce que l’on sait ou a déjà deviné. Il y a bien quelques informations à grapillé dans les coins, mais c’est majoritairement un gâchis de temps et d’espace.
La seconde partie est consacrée aux fondamentaux de l’extensibilité d’Eclipse. Le but ici est de comprendre les points d’extensions, les notions de base des frameworks fondamentaux (SWT, JFace) et d’être en mesure de créer un plugin. On en prends pour 130 pages et 7 chapitres, et c’est curieusement plus intéressant et plus instructif que la première partie.
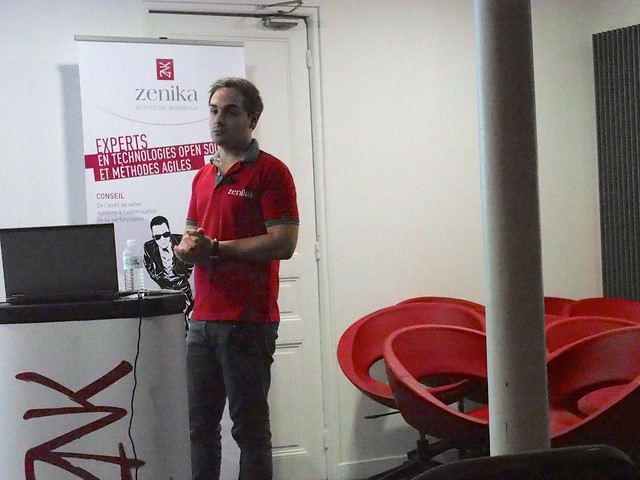
Le Storm User Group, c’est une initiative de quelques collègues autour du « big data temps réel ». Aujourd’hui, nous parlons de Storm et quelques infrastructures qui peuvent s’y connecter. Demain, il s’agira peut-être de Spark ou d’autres…
Halte là ! Je vais peut-être un peu vite ? Et d’abord, Storm, qu’est-ce que c’est ? Voilà une question à laquelle une partie de cette première rencontre va être consacrée.
C’est Florian Hussonois qui va répondre à cette question. Nous pourrions résumer la chose en déclarant simplement qu’il s’agit d’un Hadoop « temps réel ». Il s’agit en quelque sorte d’un middleware permettant le traitement d’évènements en mode flux.
Storm a été développé par Nathan Marz chez BackType en 2011. La société est rachetée ensuite par Twitter qui promeut le projet et le passe en Open-Source. La première release officielle date de 2011. En Septembre 2014, le projet devient officiellement « Apache Top Level Project » alors même qu’il n’a pas encore atteint la release 1.0 !
Ecrit principalement en Clojure et en Java, ce « processeur d’évènements » est conçu pour traiter un flux de très nombreux évènements (des tuples dans la terminologie Storm), à savoir 1 millions de tuples par seconde et par noeud (1 seul coeur processeur), avec tolérance aux fautes, gestion de la scalabilité et garantie de traitement !
A company will get nowhere if all of the thinking is left to management.
Akio Morita

 Software Freethinker
